

Product
安全な生成AI活用に
必要なすべてを、
ワンパッケージで
TDSE AI Forgeは、AIサーバー、OSS LLM、AIエージェント開発基盤、ガードレール機能を統合したオンプレミス型AIエージェント基盤です。
お客様の業務や目的に応じたLLM選定から、AIエージェント開発、活用定着まで、TDSEが一貫して支援します。
ISSUES
TDSE AI Forgeの製品仕様
TDSE AI Forgeは、部門単位でのAIエージェント開発や生成AI活用を、安全に始めるためのオンプレミス型AI基盤です。小型AIサーバー、OSS LLM、AIエージェント構築基盤、ガードレール機能をワンパッケージで提供し、クラウド利用に制約がある環境や、機密情報を扱う業務にも生成AIを活用しやすい環境を構築します。
TDSEでは、導入前のヒアリングを通じて、業務内容や活用目的に応じたLLM・構成を選定し、導入後の活用まで見据えた支援をご提案します。
プリインストールS/W一覧
- ① Dify Community版(最新バージョン)※1
- AIエージェントのノーコード開発・RAG・フロー設計・運用基盤
- ② OSS LLM w/ vLLM
- 検証済のご希望LLMを選択
(例: Llama 3, Mistral, Gemma 等)
- ③ NeMoガードレール※2
- LLMの入出力制御・安全性ポリシー適用(未設定)
- ④ KVキャッシュ圧縮技術(必要な場合)
- メモリ使用量を6倍削減、推論速度を最大8倍高速化
※1 Dify Enterprise版、Dify以外のソフトウェアのインストールも可能
※2 ガードレール用にメインLLMとは別で、RedHatAI/Meta-Llama-3.1-8B-Instruct-FP8-dynamic、nvidia/llama-3.1-nemoguard-8b-content-safety、nvidia/llama-3.1-nemoguard-8b-topic-controlをインストールしています。ガードレールが不要な場合は、事前にご連絡頂ければ削除致します。
※掲載しているハードウェア構成は一例です。提供時期や調達状況に応じて、同等性能の機器・構成へ変更となる場合があります。
導入しやすい価格でご提供
TDSE AI Forge
本体価格
本体価格: 200万円~
TDSE AI ForgeはオンプレミスAI基盤、活用テーマに合わせた最適なLLM、AIエージェント構築プラットフォーム、安全に生成AIを活用するためのガードレール機能をオールインワンでご提供します。
※構成により価格は変動します。ヒアリングをもとにお見積させていただきます。
※活用支援メニュー(生成AIアセスメント、AIエージェント構築支援、QA対応、内製化支援等)は別途有償となります。
1NVIDIA DGX Spark
または互換機を採用
静粛性が高く省スペース、オフィス内設置が可能なNVIDIA DGX Spark 又は互換器の小型AIサーバーを採用。デスクトップサイズでありながら、最大2000億パラメータのAIモデルをローカル処理できる高性能モデルです。
クラウドに依存せず、AIエージェントやAIモデルをローカル環境で実行でき、高度なAI開発環境をご提供します。
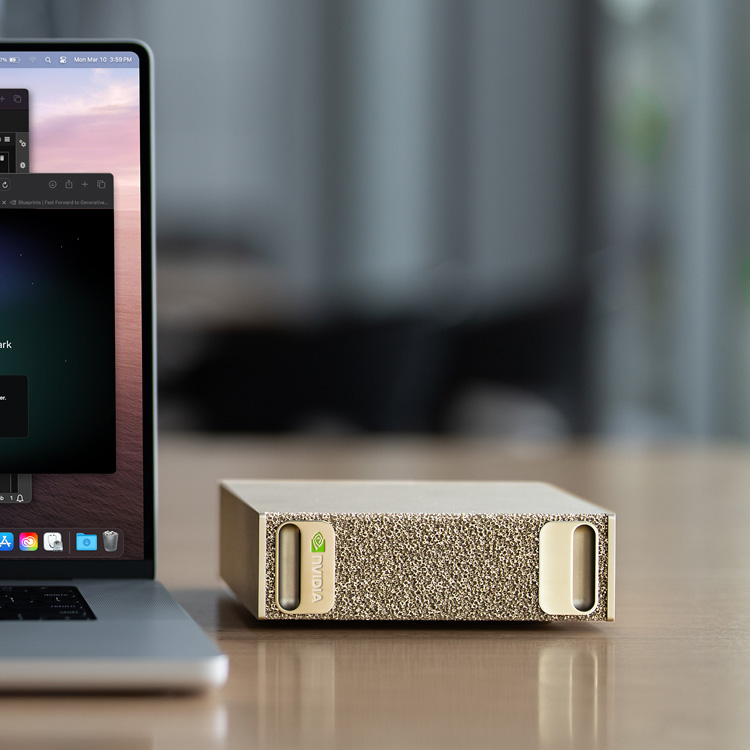
| NVIDIA DGX Spark仕様 | |
|---|---|
| SoC | NVIDIA GB10 Grace Blackwell Superchip |
| GPU | Blackwell GPU(第5世代 Tensor Core) |
| CPU | Arm 20コア |
| メモリ | 128GB LPDDR5X(統合メモリ) |
| 対応モデル | 推論:最大 約200B params(量子化) ※推奨:70B params |
| ストレージ | 1TB / 4TB NVMe(Self-Encrypting) |
| 電源 | 100V対応(一般コンセント) |
※掲載しているハードウェアは一例です。提供時期や調達状況に応じて、同等性能の機器・構成へ変更となる場合があります。
2NVIDIA NeMo Guardrails -
AIの安全性と信頼性を制御
NVIDIA NeMo Guardrailsは、生成AIの回答内容や会話の流れを制御し、安全で信頼性の高いAI活用を支えるガードレール機能です。
業務外の質問、不適切な出力、個人情報の取り扱い、プロンプトインジェクションなどのリスクを抑制し、企業内で生成AIを安心して利用できる環境を実現します。TDSE AI Forgeでは、部門や業務ごとのルールに合わせて、AIエージェントの振る舞いを柔軟に制御できます。
| トピック制御 会話を業務範囲内に誘導 |
|
|---|---|
| 入出力バリデーション ユーザー入力とAI応答を双方向で検証 |
|
| RAGグラウンディング 回答の事実性を検証し幻覚を抑制 |
|
| ジェイルブレイク防御 AIの安全制約を回避する攻撃を検出 |
|
3OSS LLMラインナップ -
導入前に
生成AI活用要件を
ヒアリングし最適なLLMを選定
OSS LLMは、用途に応じて選択できるオープンソースの大規模言語モデルです。日本語業務に強いモデル、軽量で高速なモデル、推論性能に優れたモデルなど、各モデルには異なる特長があります。
導入前に業務内容や活用目的をヒアリングし、性能・コスト・運用性を踏まえて最適なOSS LLMをご提案します。お客様自身で利用したいLLMを選択いただくことも可能です。
| ユースケース | 推奨モデル | 提供元 | 特長・選定理由 |
|---|---|---|---|
| 日本語業務 | Llama-3.1-Swallow 70B | 東工大/産総研 | 日本語コーパスで継続事前学習。敬語・専門用語に強く、 社内QAや稟議・報告書ドラフト生成に有効。 |
| 軽量エージェント | Llama 3.1 8B Instruct | Meta | 低レイテンシ・並列処理に強く、意図分類・検索クエリ生成等のサブエージェントに最適。 |
| マルチモーダル軽量 | Gemma 4 31B | 画像・音声対応のマルチモーダルモデル。 多言語性能に優れ、1GPU運用が可能な軽量設計。 |
|
| 高効率推論 | Phi-4 14B | Microsoft | 14Bパラメータながら大型モデルに匹敵する推論性能。 エッジ展開やコスト重視の用途に最適。 |
| エージェント推論 | gpt-oss-20b | OpenAI | MoE構成で5.1B活性化。 Apache 2.0ライセンス、単一GPU運用で高い推論性能を実現。 |
| 多言語・コード生成 | Mistral-Large- Instruction-2407(22B/MoE) |
Mistral AI | 最大128Kコンテキスト、80以上のコード言語対応。 数学・推論性能に優れた大規模モデル。 |
導入しやすい価格でご提供
TDSE AI Forge
本体価格
本体価格: 200万円~
TDSE AI ForgeはオンプレミスAI基盤、活用テーマに合わせた最適なLLM、AIエージェント構築プラットフォーム、安全に生成AIを活用するためのガードレール機能をオールインワンでご提供します。
※構成により価格は変動します。ヒアリングをもとにお見積させていただきます。
※活用支援メニュー(生成AIアセスメント、AIエージェント構築支援、QA対応、内製化支援等)は別途有償となります。
4KVキャッシュ圧縮 -
推論効率を大幅改善
KVキャッシュ圧縮は、LLMの推論時に使用されるメモリを圧縮し、GPUリソースを効率的に活用するための技術です。
長文のやり取りや複数ユーザーの同時利用ではメモリ消費が大きくなりますが、KVキャッシュ圧縮により、メモリ使用量を抑えながら応答性能を維持しやすくなります。部門利用におけるAIエージェントやRAGの実行効率を高め、より安定した生成AI活用を支えます。
| メモリ6倍削減 KVキャッシュを3ビットに圧縮 |
|
|---|---|
| Attention計算8倍効率化 PolarQuant+QJLの2段階方式 |
|
| 精度劣化なし 品質を維持したまま圧縮 |
|
| キャリブレーション不要 即座に適用可能 |
|
5AIエージェント基盤 -
ノーコードでAIエージェントを構築・運用
ノーコードでAIアプリケーションやワークフローを構築できるAIエージェント基盤をプリインストールしています。
チャットボット、RAG、外部API連携を伴うAIエージェントなど、画面上で直感的に設計できるため、業務部門でも生成AI活用を始めやすくなります。
Dify Community版、Enterprise版など、プリインストールするAIエージェント基盤はご選択いただけます。
※ご要望により、Dify Enterprise版、その他のエージェント基盤のインストールも可能。
| ビジュアルワークフロー 直感的なUIでAIフローを設計 |
|
|---|---|
| RAG エンジン 社内文書を活用した高精度な回答生成 |
|
| AIエージェント 自律的に判断・実行するAIを構築 |
|
| マルチモデル対応 用途に応じてLLMを柔軟に切替 |
|
TDSE AI Forge ご留意事項
TDSE AI Forge
ご留意事項について
- 部門単位での生成AI活用を目的としたAI基盤で、1つのAIノードとして動作します。
- クラウド型生成AIと異なり、計算資源(GPU・メモリ)は社内の利用者間で共有されます。
- 複数ユーザーの同時アクセスに対応しますが、GPUは1基のため重い処理を同時実行するとキューイングが発生します。
- 適正利用規模の目安は1台構成で部門15~30名程度の同時アクセス・断続利用(LLMが30B以下の場合)。快適利用は50名程度が上限です。
- 対話/RAG中心の業務利用やAIエージェント活用に適合。常時の長文生成・大規模学習は別環境を推奨します。
Difyとは
AIチャットボットや文章要約などの生成AIアプリ、AIエージェントをノーコードで構築できるプラットフォームです。
Difyを活用することでノーコードで以下のような仕組みを構築・活用することが可能です。
- FAQ/マニュアルをもとにAIチャットボットを構築
- PDF・Excel・社内データをRAGで検索・回答を活用
- 要約・翻訳・文書作成などをワークフロー化
TDSE株式会社は、株式会社LangGenius(Difyの開発元・日本法人) が提供するDifyの公式販売・構築パートナーとして、
Difyの販売から環境構築・活用支援・研修等までご支援しています。
導入しやすい価格でご提供
TDSE AI Forge
本体価格
本体価格: 200万円~
TDSE AI ForgeはオンプレミスAI基盤、活用テーマに合わせた最適なLLM、AIエージェント構築プラットフォーム、安全に生成AIを活用するためのガードレール機能をオールインワンでご提供します。
※構成により価格は変動します。ヒアリングをもとにお見積させていただきます。
※活用支援メニュー(生成AIアセスメント、AIエージェント構築支援、QA対応、内製化支援等)は別途有償となります。
FOUR REASONS
TDSE AI Forgeが
選ばれる理由
01
部門から始められる
スモールスタート設計
大規模な全社展開を前提とせず、まずは部門単位でAI活用を開始できます。
小さく始めて成果を見極めながら、段階的に活用範囲を拡大できます。
02
セキュアなAI・
AIエージェント活用環境
オンプレミス環境により、機密情報やクラウドに出せないデータも活用可能です。ガバナンスやセキュリティを考慮した設計により、安全な生成AI活用を実現します。
03
最新のOSS LLMを活用可能
Llama、Gemma、Mistral、Qwen、Swallowなど、用途や要件に応じて最適なOSS LLMを選択可能です。
特定ベンダーのモデルに依存せず、最新の技術動向を取り込みながら柔軟に活用できます。
04
TDSEが活用まで
一気通貫でサポート
AI基盤を導入して終わりではありません。
モデル選定やAI活用に関する技術相談など、データサイエンス企業として培った知見をもとに、利用用途に合わせた最適なLLMの選定や、導入後の活用に関するご相談もお引き受けするなど、お客様のAI活用をトータルにご支援可能です。
FAQ
よくある質問
TDSE AI ForgeではどのようなLLMを利用できますか?
TDSE AI Forgeでは、用途に応じてOSS LLMを選択して利用できます。お客様自身で利用したいLLMを選択いただくことも可能です。
また、TDSEが業務内容や活用目的をヒアリングし、性能・コスト・運用性を踏まえたLLMをご提案することも可能です。
同時利用は何人くらいまで可能ですか?
利用人数は、モデルサイズ、処理内容、利用頻度、応答速度の要件などにより変動します。TDSE AI Forgeは部門単位での利用を想定しており、想定ユースケースをヒアリングしたうえで適切な構成をご提案します。
大規模な学習やファインチューニングにも利用できますか?
用途やモデル規模によります。TDSE AI Forgeは、部門用途での対話、RAG中心の業務利用、AIエージェント活用などに適しています。
常時の大規模学習や大規模クラウドAIの代替を目的とする場合は、別途要件を確認したうえで最適な構成をご提案します。
利用者や用途が増えた場合、拡張は可能ですか?
はい。利用人数や用途の拡大に応じて、複数台構成や上位構成への拡張を検討できます。導入時だけでなく、将来的な利用拡大も見据えて最適な構成をご提案します。
クラウド接続がない閉域環境でも利用できますか?
はい。TDSE AI Forgeはオンプレミス環境での利用を前提としているため、クラウド接続に制約がある工場、研究開発部門、機密情報を扱う業務などでも検討しやすい構成です。詳細なネットワーク要件は、導入環境を確認したうえでご案内します。
CONTACT
安全なオンプレミス環境で、
AI活用の可能性を広げる
まずは、お客様の課題や
活用イメージをお聞かせください。